发布者:售前小鑫 | 本文章发表于:2021-09-03
快快网络的高防服务器有哪些?我们先来了解下高防服务器,简而言之,“高防服务器”就是可以为公司抵御DDOS/CC攻击的服务器。在云计算时代,端游、APP软件、金融业、电商等有要求的业务能够通过接入DDOS高防服务来得到这种高防的能力。
快快网络高防业务主要分为几个机房:扬州、宁波、安溪、厦门、东莞、杭州。
主要防御比较高端的是扬州BGP、宁波BGP和安溪。
特别是扬州BGP的拥有清洗段的,专门针对大攻击业务,DDOS清洗效果在业内属于顶尖水平。
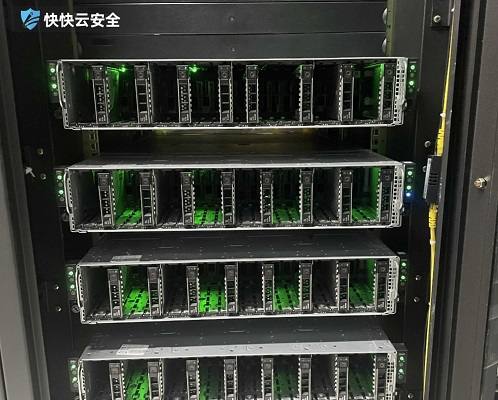
高防服务器认准快快网络——联系客服小鑫QQ:98717255
快快云服务器的优势与特点
快快云服务器的优势与特点。从性能、稳定性、灵活性、安全性和支持服务等多个角度分析,揭示快快云服务器在云计算领域的领先地位。通过综合评估其特点和优势,读者能够更好地了解快快云服务器为用户带来的价值和优势所在。全文探讨:性能优势:分析快快云服务器的处理器性能、内存容量和存储性能。比较其与其他云服务器的性能优势。稳定性评估:探讨快快云服务器的稳定性和可靠性,包括故障转移和数据冗余功能。分析其在高负载和突发流量下的表现。灵活性分析:研究快快云服务器提供的灵活配置选项,包括计算、存储和网络。探讨其支持的弹性计算和弹性存储功能。安全性考量:分析快快云服务器的安全措施,包括数据加密、访问控制和安全审计功能。探讨其应对DDoS攻击和数据泄露的防护能力。支持服务比较:对比快快云服务器的技术支持、客户服务和文档资源等支持服务。分析其提供的管理工具和监控功能。总结归纳:快快云服务器以其出色的性能、稳定性、灵活性、安全性和优质的支持服务脱颖而出。通过综合分析其在各个方面的优势,可以发现快快云服务器在云计算领域的卓越地位。用户选择快快云服务器能够获得高性能、可靠稳定的云计算资源,并享受到专业的技术支持和优质的客户服务。
APP业务要用什么配置的服务器
选择合适的APP服务器是确保应用稳定运行与良好用户体验的关键。在挑选时,需综合考量应用需求、服务器类型、硬件配置、安全性、可扩展性、成本效益以及服务商的技术支持与服务等多方面因素。一、如何确定搭建APP需要什么硬件配置用户规模与流量:预估用户数量、并发访问量及增长趋势,例如初创APP可选择轻量级服务器,而高流量应用需高性能独立服务器或云服务器。数据存储需求:根据数据量大小选择存储容量,如用户上传图片、视频等大文件需大容量存储方案。业务类型:游戏、视频等实时性要求高的应用需低延迟服务器;电商、社交等需高并发处理能力。二、怎么选择服务器类型独立服务器:优势:提供独立资源和高性能,适合对性能有较高要求、大流量的APP。成本:相对较高,需考虑硬件购置、运维等费用。云服务器:特点:基于云计算技术,具有高可用性和弹性扩展能力,可根据实际需求动态调整资源。优势:适合各种规模的APP,尤其是需要快速响应市场变化的应用;提供自动化的部署、扩展和管理功能,降低运维成本。推荐:如阿里云、腾讯云等主流云服务商提供多种配置和价格选择,满足不同需求。容器化服务器:技术:通过容器技术将应用和环境隔离,提供轻量级、灵活和可移植的部署方式。适用场景:适合微服务架构的APP,可以快速部署和扩展。三、考虑操作系统与硬件配置操作系统:Linux:以稳定性和安全性著称,适合大多数应用场景;支持多种编程语言和框架。Windows:提供更友好的用户界面和丰富的功能,适合对操作系统有特殊要求的APP。硬件配置:CPU:负责执行计算任务,需根据APP的预期流量和访问量评估计算能力。内存:决定服务器能同时处理多少任务,应根据APP的用户规模和并发量合理配置。存储:确保足够的存储空间来存储用户数据和应用文件,可考虑使用SSD硬盘提高性能。四、如何确保安全性与可扩展性安全性:防护措施:选择具有防火墙、入侵检测、数据加密等安全功能的服务器。安全认证:考虑通过ISO27001等安全认证的服务商。可扩展性:横向扩展:支持增加服务器数量以提高处理能力。纵向扩展:支持升级服务器硬件配置以提高性能。云服务优势:云服务器和容器化服务器在这方面具有天然优势,可按需扩展资源。五、如何评估成本效益硬件投入:考虑服务器的购置成本、运维成本等。带宽费用:根据APP的流量需求选择合适的带宽套餐。性价比:选择性价比高的服务器提供商,避免过度投资或低质量服务。六、服务商需要提供哪些技术支持与服务技术支持:选择具有专业技术支持团队的服务商,能够提供及时、有效的解决方案。售后服务:了解服务商的售后服务政策、故障响应时间和数据恢复能力等。选APP服务器要全面权衡各项因素,结合自身实际需求与预算,做出明智决策。只有选对服务器,才能为APP的发展奠定坚实基础,确保其在激烈的市场竞争中脱颖而出,持续稳定地为用户提供优质服务。
什么是AI大模型?AI大模型需要多少算力支持?
从ChatGPT到DeepSeek,AI大模型正以前所未有的速度重塑着生产与生活方式。这些强大的智能系统究竟是如何工作的?支撑它们运转又需要怎样的算力基础?本文将清晰定义AI大模型的核心概念与技术本质,并系统解析其从训练到推理全生命周期的算力需求,帮助大家全面理解这一驱动AI革命的关键技术。AI大模型的定义与技术本质AI大模型是指基于海量数据训练、拥有大规模参数规模,并具备强大通用智能能力的人工智能模型。其本质是通过深度学习算法从数据中学习规律,实现对文本、图像、音频等多模态信息的理解、生成、推理和决策。大模型的核心特征体现在参数规模庞大,参数作为模型学习知识的神经元连接权重,规模通常以亿或千亿为单位,早期GPT-3有1750亿参数,当前顶尖模型已突破万亿甚至十万亿级别。海量数据训练是其另一关键特征,训练数据涵盖文本、图像、代码等,量级可达万亿token。当模型规模和数据量达到临界点时,会涌现出未被专门训练的能力,例如复杂推理、跨领域联想等,这是大模型智能性的核心体现。大模型被视为智能时代的操作系统,正在降低AI应用门槛,推动产业升级。大模型训练阶段的算力需求训练一个顶级大语言模型所需的计算资源已增长数百万倍。从早期的BERT(3.4亿参数)到GPT-3(1750亿参数),再到2025年的超大规模模型,计算需求呈现指数级上升。训练阶段的计算特点极为苛刻:它是计算密集型,需要执行大量矩阵乘法和梯度计算;内存密集型,需要存储模型参数、梯度和中间激活值;通信密集型,分布式训练需要大量跨设备通信。单次GPT-4训练运行成本约为1亿美元,需要25,000个A100 GPU连续运行90天。Grok3在训练中使用了20万张高性能GPU,远超GPT-4的2.5万张。训练一个万亿参数级别的大语言模型可能需要10,000-100,000个高端GPU/TPU核心,持续训练2-6个月,计算成本达数千万至数亿美元。这种算力需求的激增使得单一架构难以满足,异构算力成为必然选择。大模型推理阶段的算力需求与训练相比,推理阶段的计算特点有所不同。推理是延迟敏感的,用户交互场景对响应时间有严格要求;需要高吞吐量以服务大规模用户;内存访问模式更规律;精度可适当降低以提升效率。推理工作负载处理具有毫秒级延迟要求的单个请求,批处理大小通常在1到32之间,受延迟约束而非内存容量限制。到2029年,推理将占AI计算的65%,代表AI系统生命周期成本的80-90%。目前推理成本已从每百万token 20美元降至0.07美元。推理部署越来越多地采用针对成本效益优化的GPU,如NVIDIA L40S或L4,AMD MI210等。运行70亿参数模型的小规模项目需要16至24GB显存,处理130亿至300亿参数的中等规模部署需要32至80GB显存。AI大模型是基于海量数据和大规模参数训练出的智能系统,其强大能力与巨量算力需求密不可分。训练阶段需要成千上万GPU持续数月,投入数亿美元;推理阶段则更关注延迟和成本效率,每百万token成本已降至不足一毛钱。训练与推理的算力需求分化正推动基础设施走向专门化设计。随着芯片产能和电力供应成为瓶颈,算法创新与异构算力融合将成为未来AI发展的关键路径。
2021-08-26 16:16:11
2021-05-20 17:21:07
2022-01-14 13:49:29
2021-12-10 10:50:52
2022-02-08 11:07:18
2021-05-24 16:54:24
2021-10-20 15:49:34
2021-11-04 17:40:21
2021-08-26 16:16:11
2021-05-20 17:21:07
2022-01-14 13:49:29
2021-12-10 10:50:52
2022-02-08 11:07:18
2021-05-24 16:54:24
2021-10-20 15:49:34
2021-11-04 17:40:21
发布者:售前小鑫 | 本文章发表于:2021-09-03
快快网络的高防服务器有哪些?我们先来了解下高防服务器,简而言之,“高防服务器”就是可以为公司抵御DDOS/CC攻击的服务器。在云计算时代,端游、APP软件、金融业、电商等有要求的业务能够通过接入DDOS高防服务来得到这种高防的能力。
快快网络高防业务主要分为几个机房:扬州、宁波、安溪、厦门、东莞、杭州。
主要防御比较高端的是扬州BGP、宁波BGP和安溪。
特别是扬州BGP的拥有清洗段的,专门针对大攻击业务,DDOS清洗效果在业内属于顶尖水平。
高防服务器认准快快网络——联系客服小鑫QQ:98717255
快快云服务器的优势与特点
快快云服务器的优势与特点。从性能、稳定性、灵活性、安全性和支持服务等多个角度分析,揭示快快云服务器在云计算领域的领先地位。通过综合评估其特点和优势,读者能够更好地了解快快云服务器为用户带来的价值和优势所在。全文探讨:性能优势:分析快快云服务器的处理器性能、内存容量和存储性能。比较其与其他云服务器的性能优势。稳定性评估:探讨快快云服务器的稳定性和可靠性,包括故障转移和数据冗余功能。分析其在高负载和突发流量下的表现。灵活性分析:研究快快云服务器提供的灵活配置选项,包括计算、存储和网络。探讨其支持的弹性计算和弹性存储功能。安全性考量:分析快快云服务器的安全措施,包括数据加密、访问控制和安全审计功能。探讨其应对DDoS攻击和数据泄露的防护能力。支持服务比较:对比快快云服务器的技术支持、客户服务和文档资源等支持服务。分析其提供的管理工具和监控功能。总结归纳:快快云服务器以其出色的性能、稳定性、灵活性、安全性和优质的支持服务脱颖而出。通过综合分析其在各个方面的优势,可以发现快快云服务器在云计算领域的卓越地位。用户选择快快云服务器能够获得高性能、可靠稳定的云计算资源,并享受到专业的技术支持和优质的客户服务。
APP业务要用什么配置的服务器
选择合适的APP服务器是确保应用稳定运行与良好用户体验的关键。在挑选时,需综合考量应用需求、服务器类型、硬件配置、安全性、可扩展性、成本效益以及服务商的技术支持与服务等多方面因素。一、如何确定搭建APP需要什么硬件配置用户规模与流量:预估用户数量、并发访问量及增长趋势,例如初创APP可选择轻量级服务器,而高流量应用需高性能独立服务器或云服务器。数据存储需求:根据数据量大小选择存储容量,如用户上传图片、视频等大文件需大容量存储方案。业务类型:游戏、视频等实时性要求高的应用需低延迟服务器;电商、社交等需高并发处理能力。二、怎么选择服务器类型独立服务器:优势:提供独立资源和高性能,适合对性能有较高要求、大流量的APP。成本:相对较高,需考虑硬件购置、运维等费用。云服务器:特点:基于云计算技术,具有高可用性和弹性扩展能力,可根据实际需求动态调整资源。优势:适合各种规模的APP,尤其是需要快速响应市场变化的应用;提供自动化的部署、扩展和管理功能,降低运维成本。推荐:如阿里云、腾讯云等主流云服务商提供多种配置和价格选择,满足不同需求。容器化服务器:技术:通过容器技术将应用和环境隔离,提供轻量级、灵活和可移植的部署方式。适用场景:适合微服务架构的APP,可以快速部署和扩展。三、考虑操作系统与硬件配置操作系统:Linux:以稳定性和安全性著称,适合大多数应用场景;支持多种编程语言和框架。Windows:提供更友好的用户界面和丰富的功能,适合对操作系统有特殊要求的APP。硬件配置:CPU:负责执行计算任务,需根据APP的预期流量和访问量评估计算能力。内存:决定服务器能同时处理多少任务,应根据APP的用户规模和并发量合理配置。存储:确保足够的存储空间来存储用户数据和应用文件,可考虑使用SSD硬盘提高性能。四、如何确保安全性与可扩展性安全性:防护措施:选择具有防火墙、入侵检测、数据加密等安全功能的服务器。安全认证:考虑通过ISO27001等安全认证的服务商。可扩展性:横向扩展:支持增加服务器数量以提高处理能力。纵向扩展:支持升级服务器硬件配置以提高性能。云服务优势:云服务器和容器化服务器在这方面具有天然优势,可按需扩展资源。五、如何评估成本效益硬件投入:考虑服务器的购置成本、运维成本等。带宽费用:根据APP的流量需求选择合适的带宽套餐。性价比:选择性价比高的服务器提供商,避免过度投资或低质量服务。六、服务商需要提供哪些技术支持与服务技术支持:选择具有专业技术支持团队的服务商,能够提供及时、有效的解决方案。售后服务:了解服务商的售后服务政策、故障响应时间和数据恢复能力等。选APP服务器要全面权衡各项因素,结合自身实际需求与预算,做出明智决策。只有选对服务器,才能为APP的发展奠定坚实基础,确保其在激烈的市场竞争中脱颖而出,持续稳定地为用户提供优质服务。
什么是AI大模型?AI大模型需要多少算力支持?
从ChatGPT到DeepSeek,AI大模型正以前所未有的速度重塑着生产与生活方式。这些强大的智能系统究竟是如何工作的?支撑它们运转又需要怎样的算力基础?本文将清晰定义AI大模型的核心概念与技术本质,并系统解析其从训练到推理全生命周期的算力需求,帮助大家全面理解这一驱动AI革命的关键技术。AI大模型的定义与技术本质AI大模型是指基于海量数据训练、拥有大规模参数规模,并具备强大通用智能能力的人工智能模型。其本质是通过深度学习算法从数据中学习规律,实现对文本、图像、音频等多模态信息的理解、生成、推理和决策。大模型的核心特征体现在参数规模庞大,参数作为模型学习知识的神经元连接权重,规模通常以亿或千亿为单位,早期GPT-3有1750亿参数,当前顶尖模型已突破万亿甚至十万亿级别。海量数据训练是其另一关键特征,训练数据涵盖文本、图像、代码等,量级可达万亿token。当模型规模和数据量达到临界点时,会涌现出未被专门训练的能力,例如复杂推理、跨领域联想等,这是大模型智能性的核心体现。大模型被视为智能时代的操作系统,正在降低AI应用门槛,推动产业升级。大模型训练阶段的算力需求训练一个顶级大语言模型所需的计算资源已增长数百万倍。从早期的BERT(3.4亿参数)到GPT-3(1750亿参数),再到2025年的超大规模模型,计算需求呈现指数级上升。训练阶段的计算特点极为苛刻:它是计算密集型,需要执行大量矩阵乘法和梯度计算;内存密集型,需要存储模型参数、梯度和中间激活值;通信密集型,分布式训练需要大量跨设备通信。单次GPT-4训练运行成本约为1亿美元,需要25,000个A100 GPU连续运行90天。Grok3在训练中使用了20万张高性能GPU,远超GPT-4的2.5万张。训练一个万亿参数级别的大语言模型可能需要10,000-100,000个高端GPU/TPU核心,持续训练2-6个月,计算成本达数千万至数亿美元。这种算力需求的激增使得单一架构难以满足,异构算力成为必然选择。大模型推理阶段的算力需求与训练相比,推理阶段的计算特点有所不同。推理是延迟敏感的,用户交互场景对响应时间有严格要求;需要高吞吐量以服务大规模用户;内存访问模式更规律;精度可适当降低以提升效率。推理工作负载处理具有毫秒级延迟要求的单个请求,批处理大小通常在1到32之间,受延迟约束而非内存容量限制。到2029年,推理将占AI计算的65%,代表AI系统生命周期成本的80-90%。目前推理成本已从每百万token 20美元降至0.07美元。推理部署越来越多地采用针对成本效益优化的GPU,如NVIDIA L40S或L4,AMD MI210等。运行70亿参数模型的小规模项目需要16至24GB显存,处理130亿至300亿参数的中等规模部署需要32至80GB显存。AI大模型是基于海量数据和大规模参数训练出的智能系统,其强大能力与巨量算力需求密不可分。训练阶段需要成千上万GPU持续数月,投入数亿美元;推理阶段则更关注延迟和成本效率,每百万token成本已降至不足一毛钱。训练与推理的算力需求分化正推动基础设施走向专门化设计。随着芯片产能和电力供应成为瓶颈,算法创新与异构算力融合将成为未来AI发展的关键路径。
查看更多文章 > 最新活动

 闽公网安备 35020302000839号
公安机关联网备案号 35020301000110






 云安全相关活动




